Алгоритмическую секцию можно натаскать: есть условие, есть правильный ответ, есть тесты, которые либо зелёные, либо нет. System design устроен принципиально иначе. Вам говорят «спроектируйте ленту» — и на этом входные данные заканчиваются. Ни требований, ни ограничений, ни критерия, по которому через час станет понятно, справились вы или нет.
Мобильных разработчиков это выбивает из колеи особенно сильно, потому что весь доступный материал по system design написан про бэкенд. Шардирование, консистентное хеширование, реплики, «сколько запросов в секунду выдержит база» — на собеседовании на Android-позицию это не спросят. Спросят про то, что у вас лежит на диске, что происходит при потере сети, откуда берётся следующая страница ленты и почему пользователь увидел лайк дважды.
Ниже — каркас, по которому такое интервью удобно проходить, и разбор развилок, которые в нём почти гарантированно всплывут. Сквозной пример один и тот же от начала до конца: лента с твитами. Он выбран не случайно — пагинация, кеш, оффлайн, картинки и оптимистичный UI собираются в одной задаче.
Каркас интервью и подборка тем — из открытого гайда weeeBox/mobile-system-design (Alex Lementuev). У репозитория закрытая лицензия, поэтому здесь нет ни его текста, ни его диаграмм: формулировки мои, схемы нарисованы заново под этот разбор. За оригиналом — по ссылке, там же лежат разборы упражнений и подробные вкладки по отдельным темам.
Что на самом деле оценивают
Главное недоразумение, из-за которого люди заваливают эту секцию: кандидат считает, что от него ждут работающую систему. За 45 минут работающую систему не спроектировать, и интервьюер это знает лучше вас.
Оценивают не результат, а то, что вокруг него:
- как вы сужаете задачу — из «спроектируйте ленту» надо самому сделать техническое задание;
- как вы принимаете решения — не «взял Room», а «взял Room, потому что нужны запросы и миграции, и вот чем я за это плачу»;
- видите ли вы компромиссы — у любого выбранного варианта должна быть названа цена;
- как вы разговариваете — интервью это диалог, а не доклад.
Отсюда практическое следствие: озвучивайте вслух то, что обычно происходит у вас в голове молча. «Я предполагаю, что бэкенд уже есть» — это сигнал. Молча предположить то же самое — не сигнал, а мина, которая рванёт через двадцать минут, когда выяснится, что бэкенд надо было проектировать тоже.
Примерный тайминг часовой секции:
| Минуты | Что происходит |
|---|---|
| 2–5 | знакомство |
| 5 | постановка задачи и сбор требований |
| 10 | высокоуровневая схема |
| 20–30 | глубокое погружение в один-два компонента |
| 5 | ваши вопросы интервьюеру |
Обратите внимание на пропорцию: половина времени уходит на детали, но подступиться к ним можно только после первых пятнадцати минут. Кандидаты регулярно пытаются проскочить эти пятнадцать минут — и остаются без каркаса, на который детали надо навешивать.
Определите задачу, прежде чем её решать
«Спроектируйте ленту» — это три разные задачи, и первое, что нужно выяснить, какая из них ваша:
- Только клиент. Бэкенд и API уже есть, вы проектируете приложение. Самый узкий и самый предсказуемый вариант.
- Клиент и API. Вы заодно придумываете контракт: эндпоинты, формат ответов, схему пагинации, коды ошибок. Встречается чаще всего.
- Клиент, API и бэкенд. Спрашивают редко и обычно на позиции ближе к staff.
Если выпал третий вариант, а бэкенд не ваша сильная сторона, скажите об этом прямо и сразу. Это не минус: «я мобильный разработчик, серверную часть представляю на уровне общих принципов, поэтому предлагаю подробно разобрать клиент и контракт, а по бэкенду пройтись крупными мазками» — совершенно нормальная реплика. Плохо не «я этого не знаю», плохо — сорок минут уверенно нести чушь про шардирование.
Требования: три корзины
Дальше требования. Раскладывайте их по трём корзинам вслух — сам факт того, что у вас есть три корзины, уже структура.
Функциональные. Три-пять штук, не больше. Задача интервью — не перечислить всё, что умеет твиттер, а выбрать то, на чём будет интересно разговаривать:
- пользователь бесконечно скроллит ленту;
- пользователь ставит лайк;
- пользователь открывает твит и читает комментарии (только чтение).
Нефункциональные. Здесь живёт вся мобильная специфика, и именно эти пункты потом породят половину технического разговора:
- лента открывается и листается без сети — из кеша;
- лайк работает без сети и уезжает на сервер, когда сеть появится;
- экономный расход трафика, батареи и памяти.
Вне скоупа. Проговорите вслух то, что вы сознательно выкидываете, иначе через полчаса кто-нибудь про это вспомнит:
- авторизация и регистрация;
- написание твитов, ретвиты, подписки;
- аналитика и эксперименты.
Три корзины — это не бюрократия. Функциональные требования определят экраны, нефункциональные — архитектуру, а корзина «вне скоупа» защитит вас от расползания задачи.
Уточняющие вопросы
После требований — вопросы интервьюеру. Здесь работает подход «сначала вширь»: пройдитесь по десятку тем поверхностно, а потом спросите, куда копать глубже. Если предложат выбрать самому — выбирайте то, что знаете лучше.
Вопросы, которые почти всегда что-нибудь меняют в дизайне:
- Нужны ли развивающиеся рынки? Если да — на сцену выходят размер приложения, дешёвые устройства и дорогой мегабайт. Это App Bundle и динамические модули, агрессивный кеш и минимум сетевых походов.
- Сколько пользователей ожидаем? Большая аудитория — это разговор про rate limiting и экспоненциальный backoff. Приложение, которое после сбоя синхронно ретраит с миллиона устройств, устраивает бэкенду DDoS собственными силами.
- Какого размера команда? Три человека и тридцать человек — это разная нарезка на модули. На тридцати вопрос «кто кого блокирует» важнее вопроса «какой паттерн выбрать».
- Какие версии ОС и какие устройства? Отсюда следует, доступен ли вам Compose, какие API фоновой работы реально работают и сколько кода уйдёт на слои совместимости.
- Насколько данные должны быть согласованными? Счётчик лайков может быть слегка неточным пару секунд — и это развязывает руки для оптимистичного UI. Баланс на счёте не может.
- Как часто обновляются данные? Если поток плотный, опрос сервера по таймеру не годится: клиенты будут дёргать сервер вхолостую. Тогда пуши или SSE.
- Какие медиа? Картинки — одна стратегия кеша. Видео — совсем другой разговор: стриминг, HLS, транскодирование, CDN.
Не нужно задавать все семь. Нужно показать, что вы понимаете: от ответа на каждый из них дизайн меняется.
Высокоуровневая схема
Когда требования собраны, спросите, показать ли схему. Обычно да.
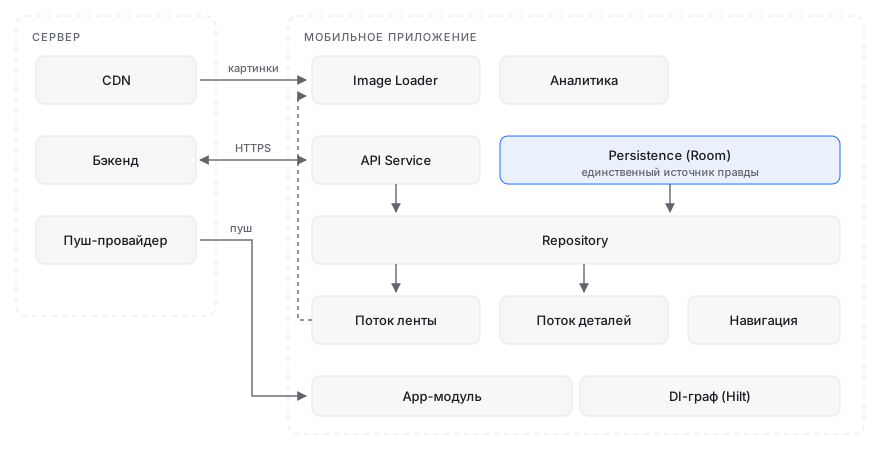
Со стороны сервера в мобильном интервью достаточно трёх коробок. Бэкенд — всё, что за HTTPS, внутрь не лезем. Пуш-провайдер (FCM, APNs) — отдельная коробка, потому что доставка через него не гарантирована и не мгновенна, и это важно для клиента. CDN — раздача картинок и видео; она принципиально отдельна от API, ходит по другим правилам и кешируется иначе.
Со стороны клиента:
- API Service — тонкая обёртка над сетью (Retrofit поверх OkHttp). Наружу отдаёт доменные модели, внутрь прячет заголовки, ретраи и разбор ошибок.
- Persistence — база на устройстве (Room). На схеме она выделена не просто так: это единственный источник правды. Всё, что показывает UI, он читает отсюда, а не из ответа сервера. Ответ сервера сначала ложится в базу и только потом доезжает до экрана.
- Repository — посредник между сетью и базой. UI не знает, откуда приехали данные.
- Поток ленты и поток деталей — экраны со своими ViewModel и состоянием.
- Навигация — переходы между потоками вынесены наружу, чтобы экраны не знали друг о друге.
- Image Loader (Coil) — отдельный компонент со своим кешем в памяти и на диске, работающий с CDN напрямую.
- DI-граф (Hilt) и app-модуль — сборка всего этого в приложение и владение жизненным циклом.
- Аналитика — отдельный модуль, чтобы события не расползались по всему коду.
Про источник правды стоит сказать вслух отдельно, потому что это одно решение, которое закрывает сразу три нефункциональных требования. Оффлайн получается бесплатно: база не знает, есть ли сеть. Мигание при возврате на экран пропадает: данные уже есть локально. И оптимистичный UI становится тривиальным: пишем в базу, экран перерисовывается сам.
Схему рисовать необязательно, но она окупается. Она за минуту задаёт словарь на весь оставшийся час: дальше можно говорить «репозиторий» и «источник правды», и вас поймут однозначно. Заодно она показывает, что вы думаете про нарезку на модули, а не только про классы. Если интервьюер схему не хочет — не настаивайте, спросите, с какого компонента начать.
Deep dive: поток ленты
Дальше интервьюер выбирает компонент и просит развернуть. Лента — самый частый выбор.
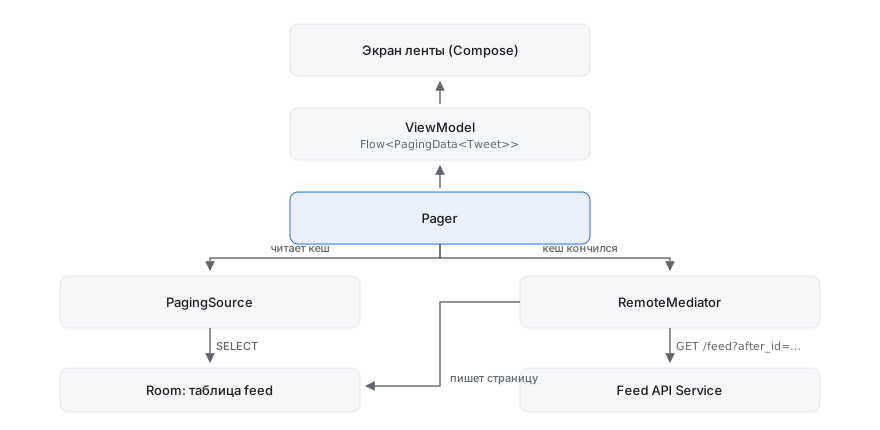
Ключевая мысль, которую стоит проговорить: разделения на «данные из сети» и «данные из кеша» на уровне UI не существует. Экран подписан на один поток. Кто и когда наполнил этот поток — его не касается.
В терминах Paging 3 это раскладывается так. PagingSource умеет только читать локальную базу. RemoteMediator просыпается, когда локальных данных не хватило, ходит в сеть и складывает результат в ту же базу. Дальше PagingSource перечитывает её и отдаёт новые элементы. Сеть и кеш не спорят за право показать данные — сеть только пополняет кеш.
@OptIn(ExperimentalPagingApi::class)
class FeedRemoteMediator(
    private val api: FeedApiService,
    private val db: AppDatabase,
) : RemoteMediator<Int, FeedItemEntity>() {

    override suspend fun load(
        loadType: LoadType,
        state: PagingState<Int, FeedItemEntity>,
    ): MediatorResult {
        val afterId = when (loadType) {
            LoadType.REFRESH -> null
            LoadType.PREPEND -> return MediatorResult.Success(endOfPaginationReached = true)
            LoadType.APPEND -> state.lastItemOrNull()?.cursorNextId
                ?: return MediatorResult.Success(endOfPaginationReached = true)
        }

        return try {
            val page = api.feed(afterId = afterId, limit = 20)
            db.withTransaction {
                if (loadType == LoadType.REFRESH) db.feedDao().clear()
                db.feedDao().insertAll(page.toEntities())
            }
            MediatorResult.Success(endOfPaginationReached = page.cursor.nextId == null)
        } catch (e: IOException) {
            // Сеть отвалилась — это не ошибка приложения.
            // Пользователь продолжает листать то, что уже лежит в базе.
            MediatorResult.Error(e)
        }
    }
}
Отдельно стоит сказать про catch. Обработка IOException здесь — не формальность: это то самое место, где оффлайн из требований превращается в код. Медиатор вернул ошибку, но PagingSource продолжает отдавать содержимое базы, и лента остаётся живой.
Про архитектурный паттерн ответ обычно ждут короткий: MVVM с однонаправленным потоком данных (по сути MVI). ViewModel держит состояние экрана, наружу отдаёт неизменяемый снимок, внутрь принимает события. MVC называть не стоит — это гарантированный вопрос «а как вы это тестируете».
Операции, которые меняют данные, лучше вынести в отдельные объекты, а не звать репозиторий из ViewModel напрямую:
class ToggleLikeUseCase(
    private val db: AppDatabase,
    private val feedDao: FeedDao,
    private val outbox: OutboxDao,
) {
    suspend operator fun invoke(tweetId: String) = db.withTransaction {
        val liked = feedDao.toggleLike(tweetId)      // сразу в базу — UI обновится сам
        outbox.enqueue(LikeOperation(tweetId, liked)) // и в очередь на отправку
    }
}
Два действия в одной транзакции — не косметика. Если приложение убьют между ними, вы получите либо лайк, который никогда не уедет на сервер, либо операцию, которой не соответствует ничего на экране.
Чем ходить в сеть
Выбор протокола — вопрос, который любят задавать, потому что на нём хорошо видно, умеет ли кандидат отказываться от лишнего.
| Протокол | Когда уместен | Чем платите |
|---|---|---|
| REST | обычные запросы за данными, кешируемые ответы | болтливость, over-fetching, нет пуша с сервера |
| GraphQL | много экранов с разной выборкой из одних сущностей | сложный клиент, HTTP-кеш почти не работает |
| WebSocket | обмен в обе стороны в реальном времени (чат) | держит соединение, ест батарею, нужна логика реконнекта |
| SSE | поток обновлений с сервера в одну сторону | только текст, только в одну сторону |
| gRPC | плотный трафик, строгий контракт, много сервисов | бинарь тяжело смотреть глазами, клиент весит |
| Пуш | разбудить приложение, когда оно не запущено | может не дойти, задержка плавает |
Для ленты правильный ответ — скучный: REST для данных плюс пуши для оповещений о новых твитах. Держать WebSocket ради ленты, которую пользователь открывает четыре раза в день, — это заплатить батареей за то, что никому не нужно.
Здесь легко попасть в ловушку: раз спросили про протоколы, кандидату хочется продемонстрировать эрудицию и взять что-нибудь посложнее. Это читается ровно наоборот — как неумение выбирать. Сказать «WebSocket здесь не нужен, и вот почему» сильнее, чем его взять.
И одна вещь про пуши, о которой забывают почти все: пуш — это не канал доставки данных, это будильник. Полезная нагрузка ограничена, порядок не гарантирован, часть пушей просто не доедет. Правильная реакция на пуш — сходить в API за настоящими данными.
Пагинация
Дальше почти всегда идёт пагинация. Вопрос выглядит безобидно, но в нём спрятана ошибка, которую совершают в проде.
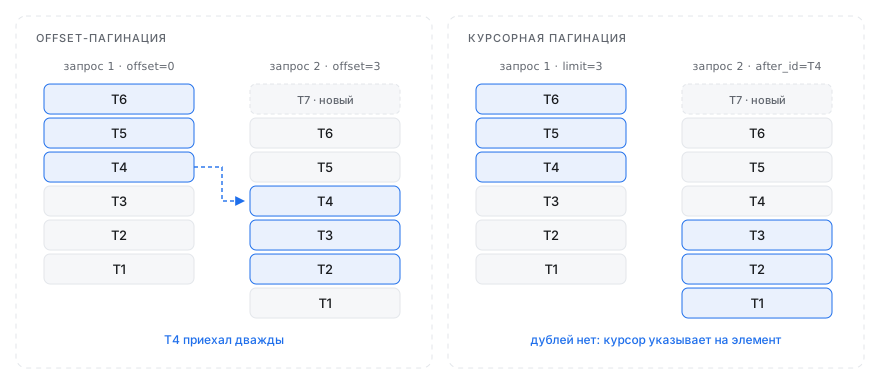
Слева — offset. Первый запрос вернул три верхних твита. Пока пользователь читал, появился новый. Второй запрос с offset=3 берёт три элемента, отсчитав их от нового начала списка — и один твит приезжает дважды. Симметричная беда случается при удалении: элемент проскакивает мимо окна и не показывается вообще.
Справа — курсор. Клиент говорит не «дай мне элементы с четвёртого», а «дай мне то, что идёт после вот этого конкретного элемента». Новые твиты сверху на это никак не влияют.
| Стратегия | Плюсы | Минусы |
|---|---|---|
| Offset | тривиально ложится на SQL, сервер без состояния | page drift, деградация на больших смещениях |
| Keyset | быстро на любом объёме, состояния нет | API протекает деталями хранилища, нужны уникальные ключи сортировки |
| Cursor | не раскрывает устройство базы, устойчив к вставкам | сложнее на сервере, курсор может протухнуть |
| Номера страниц | понятно человеку | все недостатки offset, для бесконечного скролла не годится |
Для ленты берём курсор. Ответ выглядит так:
{
  "items": [
    { "id": "t_942", "author_id": "a_17", "text": "…", "likes": 128, "created_at": "2026-08-24T09:14:03Z" }
  ],
  "cursor": { "next_id": "c_8fa21", "prev_id": null }
}
Курсор — непрозрачная строка. Клиент не должен её разбирать; всё, что ему разрешено, — вернуть её обратно в следующем запросе. Как только клиент начнёт вытаскивать из курсора дату, чтобы что-нибудь по ней отфильтровать, любое изменение схемы на сервере сломает приложения, которые уже стоят у пользователей.
Тут же стоит проговорить сетевую обвязку, это дешёвые очки:
401— токен протух, идём обновлять и повторяем запрос ровно один раз, иначе получится цикл;429и5xx— экспоненциальный backoff со случайной добавкой; без неё все клиенты, которых отбило одновременно, вернутся тоже одновременно;- версия в пути (
/v1/feed), чтобы схему пагинации можно было заменить, не ломая старые приложения. Это не теория: приложение живёт на устройствах годами, откатить релиз нельзя.
Хранение на устройстве
| Вариант | Для чего | Чем плох |
|---|---|---|
| Key-value | флаги и мелкие настройки | нет схемы и запросов, плохо на объёме |
| СУБД | данные, которые надо искать и обновлять | нужны схема и миграции, файл растёт |
| Файлы | картинки, видео, вложения | нет запросов, за размером следите сами |
| Secure storage | ключи и токены | медленно, мало места, нужна блокировка экрана |
На Android это DataStore, Room поверх SQLite, обычные файлы и связка Keystore с EncryptedSharedPreferences. Названия не главное: важно, что выбор между строчками таблицы вы объясняете, а не просто называете библиотеку.
Дальше два вопроса, которые часто сваливают в один, а они разные.
Где лежит. Internal — песочница приложения, другим приложениям не видно, при удалении стирается. External и scoped storage — общее пространство, доступ по разрешениям, переживает удаление приложения. Всё, что хоть немного чувствительно, — только internal.
Чем является. Документы бэкапятся в облако автоматически, кеш система может стереть в любой момент под нехватку места, temp живёт до конца сессии. Классическая ошибка — положить в кеш то, что нельзя восстановить, и однажды это потерять.
Для ленты: сами твиты — в Room, вложения — файлами в internal cache.
@Entity(tableName = "feed")
data class FeedItemEntity(
    @PrimaryKey val id: String,
    val authorId: String,
    val text: String,
    val likes: Int,
    val liked: Boolean,
    val pendingLike: Boolean,   // лайк ещё не подтверждён сервером
    val createdAt: Long,
    val cursorNextId: String?,  // курсор рядом с элементом — чтобы продолжить с любого места
    val cursorPrevId: String?,
)
Курсоры хранятся вместе с элементами намеренно: приложение закрыли на середине ленты, база пережила перезапуск, и продолжить листать можно без полного рефреша.
И обязательно скажите про границы роста — этого ждут:
- держим не больше нескольких сотен записей ленты, старые вытесняем по LRU;
- кеш вложений ограничиваем по объёму (условные 200–400 МБ), тоже LRU;
- удалили твит из базы — удалите и его картинки, иначе на диске останется мусор, на который никто не ссылается.
Неограниченный кеш — это не «быстро», это «через полгода приложение занимает шесть гигабайт, и его сносят».
Offline и оптимистичный UI
Оффлайн из требований — это не «показать заглушку». Это гарантия, что действия пользователя не пропадают.
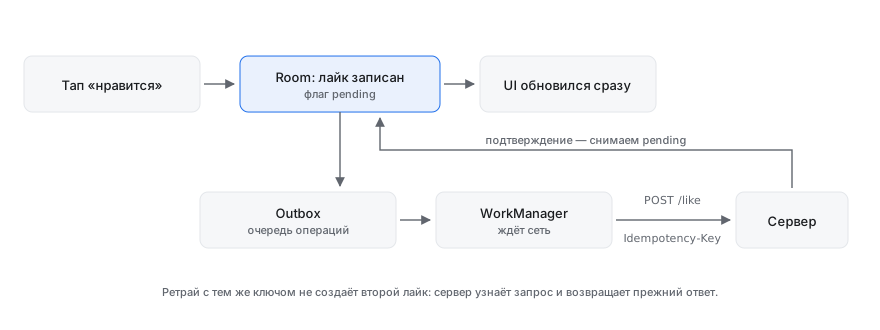
Механика: тап пишет изменение в базу и ставит флаг «не подтверждено». UI перерисовывается сразу, потому что подписан на базу. Параллельно операция кладётся в очередь исходящих. Отправкой занимается WorkManager — он переживает перезапуск приложения и умеет ждать сеть:
val request = OneTimeWorkRequestBuilder<OutboxWorker>()
    .setConstraints(
        Constraints.Builder()
            .setRequiredNetworkType(NetworkType.CONNECTED)
            .build()
    )
    .setBackoffCriteria(BackoffPolicy.EXPONENTIAL, 30, TimeUnit.SECONDS)
    .build()

workManager.enqueueUniqueWork("outbox", ExistingWorkPolicy.KEEP, request)
Дальше главный вопрос, который на интервью задают почти всегда: что будет, если ретрай дойдёт дважды? Сеть отвалилась ровно в тот момент, когда сервер уже принял запрос, но ответ не доехал. Клиент честно повторяет.
Ответ — идемпотентность. Клиент генерирует ключ операции и шлёт его заголовком:
class IdempotencyInterceptor : Interceptor {
    override fun intercept(chain: Interceptor.Chain): Response {
        val original = chain.request()
        val key = original.tag(OperationId::class.java)?.value
            ?: return chain.proceed(original)
        return chain.proceed(
            original.newBuilder().header("Idempotency-Key", key).build()
        )
    }
}
Ключ обязан быть привязан к операции и пережить ретрай. Сгенерировать UUID.randomUUID() внутри интерцептора — это ровно то, от чего мы защищаемся: на каждом повторе получится новый ключ, и смысл пропадёт. Поэтому ключ создаётся один раз при постановке операции в очередь и хранится в outbox вместе с ней.
Последнее — конфликты. Пользователь поменял что-то на телефоне без сети, потом то же самое на планшете. Разрешать это на клиенте по времени («чьи часы новее, тот и прав») — плохая идея по трём причинам: часы на устройстве выставляет пользователь, при одновременных правках данные молча теряются, а поменять правила слияния можно только выпустив новую версию приложения.
Поэтому решение принимает сервер. На клиенте остаётся три обязанности: отправить свою версию, аккуратно принять чужую и не потерять локальные изменения, которые ещё не уехали. Если данные такие, что автоматическое слияние недопустимо, сервер возвращает конфликт, а приложение показывает пользователю выбор. Для совместного редактирования существуют OT и CRDT — их достаточно назвать и сказать, что для ленты это перебор.
Сквозные темы
Их вытаскивают на любом уровне, обычно ближе к концу, когда основной разговор закончился.
Приватность. Собирайте минимум. Не привязывайтесь к неизменяемым идентификаторам устройства — берите сбрасываемые. Запрашивайте только те разрешения, без которых функциональность не работает, и будьте готовы, что откажут: система сама сбрасывает разрешения у приложений, которыми долго не пользовались. Там, где можно, отдавайте работу системным компонентам — системный выбор фото не требует доступа ко всей галерее.
Клиент или сервер. На устройстве быстрее, приватнее и работает без сети; на сервере надёжнее, обновляется без релиза и не зависит от того, какой телефон у пользователя. Но есть вещи, которые на устройстве не считают никогда: выдача промокодов и любых ценностей, проверка платежей, чувствительная бизнес-логика. Клиент разбирается за вечер — это не защита, а декорация.
Приоритеты сетевых запросов. Не все запросы равны. То, на что смотрит пользователь прямо сейчас, должно идти вперёд фоновой синхронизации и отправки аналитики. Без явных приоритетов и ограничения числа одновременных запросов очередь фона задавит интерактив, и приложение будет «тормозить» при отличной сети.
Префетч. Подгружать следующую страницу до того, как пользователь докрутил, — дёшево и заметно улучшает ощущения. Но префетч по определению тратит трафик на данные, которые могут не понадобиться. Отключайте его на мобильной сети и в режиме экономии.
Докачиваемая загрузка. Если в скоупе есть отправка видео — режьте файл на куски и грузите с возможностью продолжить. Ронять стомегабайтную загрузку на девяноста процентах из-за метро между станциями недопустимо.
Ресурсы. Трафик стоит денег, радио сажает батарею (поэтому запросы лучше складывать пачками, а не слать по одному), процессор греет телефон, память — это риск, что систему убьёт приложение в фоне, а размер приложения прямо влияет на конверсию установки.
Чего ждут на разных грейдах
Одна и та же задача на разных уровнях оценивается по разным критериям.
| Грейд | Что в фокусе |
|---|---|
| Junior | секции может не быть вовсе; базовые понятия и один компонент |
| Middle | как это реально собрать: библиотеки, слои, тесты, детали реализации |
| Senior | архитектура целиком: границы модулей, взаимодействие, обоснование выбора |
| Staff | стратегия: сроки, команда, безопасный раскат, что делать при массовом сбое |
Отсюда практический вывод: middle и senior ошибаются в разные стороны. Middle обычно проваливается в детали реализации и не поднимается на уровень системы. Senior, наоборот, иногда так и остаётся на уровне коробок и стрелочек, а на вопрос «а как именно вы это храните» ответить не может.
Частые ошибки
- Прыжок в решение. Услышал «лента» — начал рисовать. Требования не собраны, скоуп не определён, и через полчаса выясняется, что вы решали не ту задачу.
- Заученный шаблон. Кандидат воспроизводит схему из гайда, не глядя на условие. Это видно мгновенно — как только задают вопрос на шаг в сторону.
- Расползание задачи. Сами добавили себе подписки, ретвиты и рекомендации, а потом не успели рассказать про пагинацию.
- Молчание. Долгая пауза читается как «не знаю». Думайте вслух — озвучивайте даже те варианты, которые собираетесь отбросить, и говорите, почему отбрасываете.
- Перечисление названий. «Взял бы Room, Retrofit, Coil, Hilt» — это не дизайн. Дизайн начинается со слова «потому что». К тому же интервьюер может не знать конкретно ваш стек: половина крупных компаний живёт на самописных библиотеках.
- Отсутствие структуры. Мысли скачут между базой, сетью и UI. Даже если каждая по отдельности верна, целостной картины не складывается.
- Игнорирование подсказок. Если интервьюер второй раз спрашивает про оффлайн — он не поддерживает беседу, он показывает, куда идти.
- Спор ради спора. Другое мнение — это нормально и даже хорошо. Аргументируйте и слушайте контраргумент; воевать не нужно.
Шпаргалка
| Этап | Что показать |
|---|---|
| Постановка | сузили задачу, определили скоуп, назвали предположения вслух |
| Требования | три корзины, функциональных — три-пять, «вне скоупа» проговорено |
| Схема | крупные блоки, единственный источник правды, нарезка на модули |
| Deep dive | один компонент подробно, с кодом и обоснованием |
| API | протокол выбран и объяснён, курсорная пагинация, коды ошибок и backoff |
| Хранение | что где лежит, чем шифруется, как ограничен рост |
| Offline | оптимистичный UI, очередь операций, идемпотентность, конфликты решает сервер |
| Сквозное | приватность, приоритеты запросов, батарея, трафик, размер приложения |
Если запомнить одно: вас оценивают не по системе, которую вы спроектировали, а по решениям, которые вы приняли вслух и объяснили.
Каркас интервью, набор тем и подборка типичных ошибок — из гайда weeeBox/mobile-system-design. Там же лежат разборы упражнений в формате диалога кандидата с интервьюером, список типичных ошибок с обеих сторон стола и подробные вкладки по кешированию, пагинации, оффлайн-архитектуре, приоритетам запросов и докачиваемой загрузке. Текст и диаграммы здесь свои: репозиторий распространяется под закрытой лицензией.